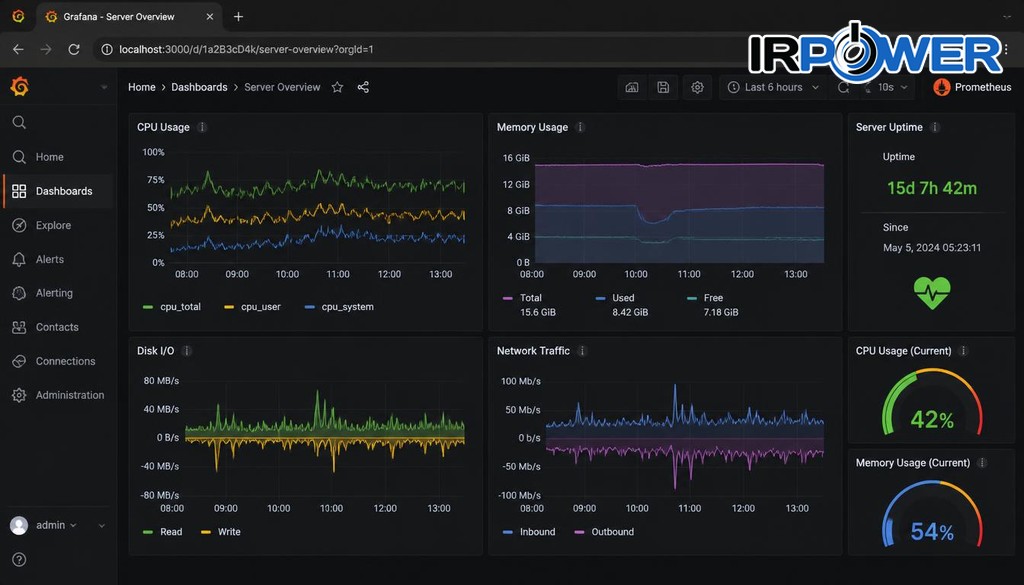
یک سرور لینوکس بدون ابزار مانیتورینگ مثل یک ماشین بدون داشبورد است. وقتی سیستم کند می شود یا سرویسی از کار می افتد، بدون ابزار مناسب باید حدس بزنید مشکل از کجاست. خوشبختانه لینوکس یکی از غنی ترین اکوسیستم های ابزارهای مانیتورینگ را دارد. از دستورات ساده ترمینال مثل top تا پلتفرم های سازمانی مثل Zabbix و Prometheus.
در این مقاله بهترین و پرکاربردترین این ابزارها را دسته بندی می کنیم و برای هر کدام توضیح می دهیم که کجا و چطور از آن استفاده کنید. فرقی نمی کند یک کاربر خانگی باشید یا مدیر یک دیتاسنتر، در این لیست چیزی برای شما پیدا می شود.
چرا مانیتورینگ در لینوکس ضروری است؟
لینوکس به عنوان سیستم عامل غالب سرورها و زیرساخت های ابری، نیازمند نظارت مداوم است. مانیتورینگ به شما کمک می کند تا مشکلات را قبل از اینکه به بحران تبدیل شوند شناسایی کنید. مثلا وقتی فضای دیسک به ۹۰ درصد می رسد، بهتر است قبل از پر شدن کامل آن اقدام کنید. یا وقتی مصرف CPU به طور غیرعادی بالا می رود، باید بدانید کدام فرآیند مسئول است. ابزارهای مانیتورینگ این اطلاعات را به صورت بلادرنگ یا تاریخی در اختیار شما قرار می دهند و به شما اجازه می دهند تصمیمات آگاهانه بگیرید.
مانیتورینگ فقط برای مدیران سرور نیست. توسعه دهندگان نرم افزار هم از این ابزارها استفاده می کنند تا عملکرد برنامه خود را بررسی کنند، حافظه را تحلیل کنند و گلوگاه های سیستم را پیدا کنند. حتی کاربران خانگی هم می توانند با ابزارهای ساده مثل htop بفهمند چرا کامپیوترشان کند شده است. بنابراین یادگیری این ابزارها برای هر کسی که با لینوکس کار می کند مفید است.
دسته بندی ابزارهای مانیتورینگ
ابزارهای مانیتورینگ لینوکس را می توان به چند دسته کلی تقسیم کرد:
-
ابزارهای خط فرمان (CLI): سریع، سبک و همیشه در دسترس. مناسب برای عیب یابی فوری.
-
ابزارهای ترمینال گرافیکی (TUI): رابط کاربری متنی زیبا با نمودار و رنگ. تعادل بین سرعت و ظاهر.
-
ابزارهای وب محور: داشبوردهای گرافیکی از طریق مرورگر. مناسب برای نظارت از راه دور.
-
پلتفرم های سازمانی: سیستم های کامل با هشداردهی، گزارش گیری و مدیریت متمرکز.
-
ابزارهای تخصصی: برای شبکه، لاگ، دیسک و حافظه.
جدول دسته بندی کلی:
| دسته | نمونه ابزارها | کاربرد اصلی |
|---|---|---|
| CLI ساده | top, vmstat, iostat, free |
عیبیابی سریع |
| TUI پیشرفته | htop, btop, glances, bottom |
نظارت تعاملی |
| وبمحور سبک | Netdata, Cockpit |
داشبورد بلادرنگ |
| سازمانی | Zabbix, Nagios, Prometheus + Grafana |
مانیتورینگ متمرکز |
| تخصصی شبکه | iftop, nethogs, vnstat |
تحلیل ترافیک |
| تخصصی لاگ | journalctl, logwatch |
بررسی رویدادها |
ابزارهای خط فرمان پایه
هر مدیر لینوکسی باید با این ابزارهای ساده و قدرتمند آشنا باشد. این دستورات روی تقریباً هر توزیعی نصب هستند و نیازی به نصب اضافی ندارند.
top و htop
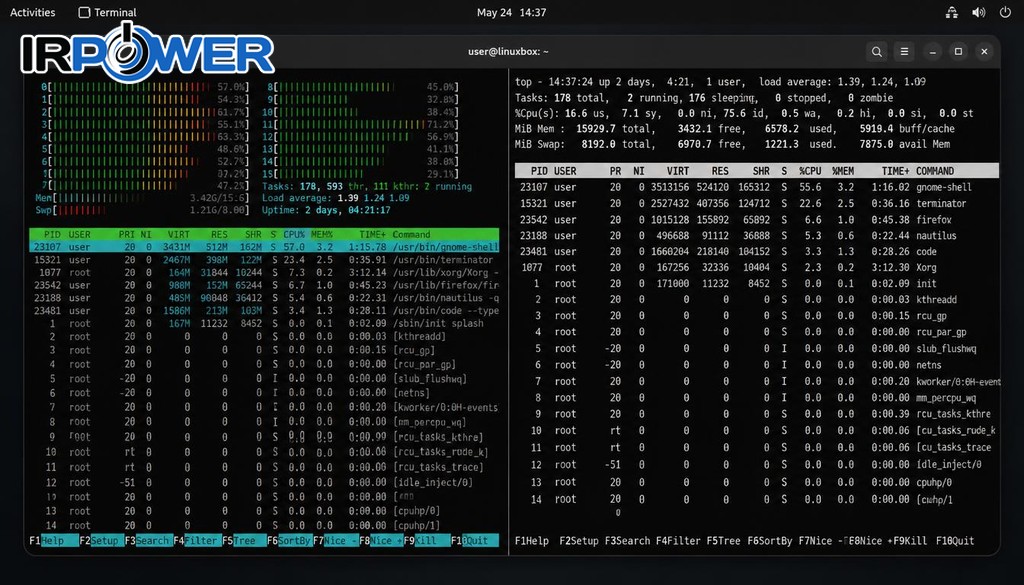
دستور top کلاسیک ترین ابزار مانیتورینگ لینوکس است. یک نمای بلادرنگ از فرآیندهای در حال اجرا، مصرف CPU، حافظه و بار سیستم ارائه می دهد. با top می توانید ببینید کدام فرآیند بیشترین منابع را مصرف می کند و با کلید k آن را ببندید.
اما htop نسخه پیشرفته و رنگی top است. رابط کاربری تعاملی، پشتیبانی از ماوس، امکان مرتب سازی بر اساس هر ستون و نمایش درختی فرآیندها از جمله مزایای آن است. نصب آن ساده است:
sudo apt install htop # Debian/Ubuntu
sudo dnf install htop # Fedora/RHEL
با htop می توانید با F3 جستجو کنید، با F9 فرآیند بکشید و با F7/F8 اولویت آن را تغییر دهید.
vmstat، iostat و sar
این سه ابزار بخشی از بسته sysstat هستند و برای تحلیل عملکرد سیستم طراحی شده اند. vmstat آمار حافظه مجازی، CPU و I/O را نمایش می دهد. iostat مخصوص بررسی عملکرد دیسک است و نشان می دهد کدام دیسک کندتر کار می کند. sar قدرتمندترین این سه است و می تواند داده های تاریخی جمع آوری کند. مثلا sar -u 5 3 سه گزارش مصرف CPU با فاصله ۵ ثانیه می دهد.
sudo apt install sysstat
vmstat 1
iostat -x 1
sar -u 5 3
dstat
dstat یک ابزار همه کاره است که خروجی vmstat، iostat، mpstat و netstat را در یک نمای واحد ترکیب می کند. با یک دستور می توانید همزمان CPU، دیسک، شبکه و حافظه را ببینید:
dstat -cdngy 5
این دستور هر ۵ ثانیه یک خط گزارش کامل چاپ می کند.
ابزارهای ترمینال گرافیکی (TUI)
اگر می خواهید ترکیبی از زیبایی و کارایی داشته باشید، ابزارهای TUI انتخاب عالی هستند. این ابزارها در ترمینال اجرا می شوند اما نمودار، رنگ و رابط تعاملی دارند.
btop
btop (که قبلا bashtop و bpytop نام داشت) محبوب ترین ابزار TUI مانیتورینگ است. با C++ نوشته شده و عملکرد بسیار خوبی دارد. در یک صفحه، CPU، حافظه، دیسک، شبکه و فرآیندها را با نمودارهای رنگی نمایش می دهد. از ماوس پشتیبانی می کند و می توانید تم آن را تغییر دهید.
sudo apt install btop
btop
glances
glances یک ابزار جامع است که تقریبا هر چیزی که فکرش را بکنید مانیتور می کند: CPU، حافظه، بار سیستم، شبکه، دیسک، دما، فن و حتی کانتینرهای Docker. مزیت بزرگ آن این است که می تواند به صورت وب سرور هم اجرا شود:
sudo apt install glance
حالت ترمینال
glances
حالت وب روی پورت 61208
glances -w
در حالت وب، از هر دستگاهی در شبکه می توانید وضعیت سرور را ببینید.
bottom
bottom (که با نام btm هم شناخته می شود) یک ابزار TUI مدرن با نمودارهای زنده است. بر خلاف htop که بیشتر روی فرآیندها تمرکز دارد، bottom تعادل خوبی بین نمودارهای گرافیکی و اطلاعات فرآیندی برقرار می کند. اگر به دنبال ظاهر مدرن و اطلاعات کامل هستید، گزینه خوبی است.
ابزارهای وب محور سبک
گاهی اوقات می خواهید از طریق مرورگر وضعیت سرور را ببینید بدون اینکه لازم باشد SSH بزنید. این ابزارها این کار را ممکن می کنند.
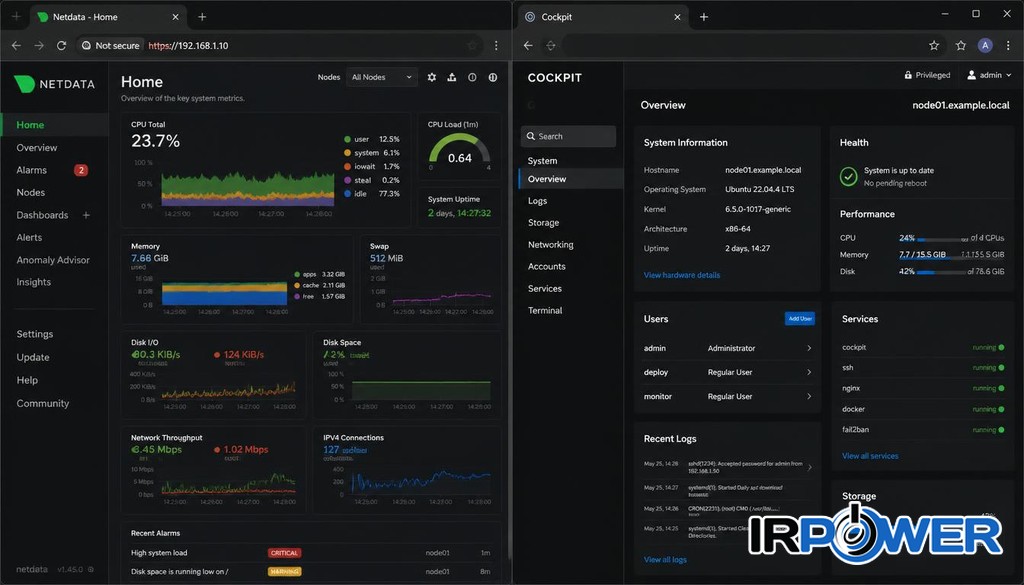
Netdata
Netdata یکی از محبوب ترین ابزارهای مانیتورینگ بلادرنگ است. با دقت میلی ثانیه ای (200ms) داده ها را جمع آوری می کند و در یک داشبورد وب زیبا با صدها نمودار تعاملی نمایش می دهد. نکته جالب اینکه با وجود این همه امکانات، مصرف منابع آن بسیار کم است (کمتر از ۵ درصد یک هسته CPU). نصب آن با یک اسکریپت ساده انجام می شود و روی پورت ۱۹۹۹۹ در دسترس است.
wget -O /tmp/netdata-kickstart.sh https://my-netdata.io/kickstart.sh
sh /tmp/netdata-kickstart.sh
بعد از نصب، در مرورگر به http://IP-SERVER:19999 بروید.
Cockpit

Cockpit یک ابزار متفاوت است: به جای اینکه فقط مانیتور باشد، یک پنل مدیریت کامل وب محور برای سرور لینوکس ارائه می دهد. می توانید از طریق آن کاربران را مدیریت کنید، سرویس ها را کنترل کنید، لاگ ها را ببینید، ترمینال وب باز کنید و منابع سیستم را مانیتور کنید. برای مدیرانی که می خواهند یک رابط گرافیکی کامل داشته باشند، Cockpit انتخاب عالی است.
sudo apt install cockpit
sudo systemctl enable --now cockpit.socket
سپس از طریق https://IP-SERVER:9090 وارد شوید.
ابزارهای تخصصی شبکه
اگر مشکل شبکه دارید یا می خواهید بفهمید کدام برنامه پهنای باند را می خورد، این ابزارها به کارتان می آیند.
iftop
iftop مثل top است اما برای شبکه. ترافیک شبکه را به صورت بلادرنگ نمایش می دهد و نشان می دهد کدام اتصال چقدر پهنای باند مصرف می کند. برای اجرا نیاز به دسترسی root دارد:
sudo apt install iftop
sudo iftop -i eth0
nethogs
nethogs یک قدم جلوتر می رود و پهنای باند را بر اساس فرآیند نمایش می دهد. یعنی دقیقا می گوید کدام برنامه در حال استفاده از شبکه است. این برای پیدا کردن برنامه های مشکوک یا فرآیندهای پر مصرف عالی است.
sudo apt install nethogs
sudo nethogs eth0
vnstat
vnstat یک ابزار سبک برای آمار تاریخی ترافیک شبکه است. بر خلاف iftop که بلادرنگ است، vnstat داده ها را در پایگاه داده ذخیره می کند و می توانید گزارش روزانه، ماهانه یا سالانه بگیرید. برای سرورهایی که می خواهید مصرف پهنای باند را در طول زمان رصد کنید، ایده آل است.
sudo apt install vnstat
vnstat -d
گزارش روزانه
vnstat -m
گزارش ماهانه
جدول مقایسه ابزارهای شبکه:
| ابزار | نوع | کاربرد اصلی |
|---|---|---|
iftop |
بلادرنگ | نمایش ترافیک هر اتصال |
nethogs |
بلادرنگ | نمایش پهنای باند هر فرآیند |
vnstat |
تاریخی | آمار بلندمدت ترافیک |
nload |
بلادرنگ | نمایش ساده ورودی/خروجی |
bmon |
بلادرنگ | نمایش گرافیکی پهنای باند |
ابزارهای تخصصی لاگ
لاگ ها گنجینه ای از اطلاعات هستند. هر اتفاقی که در سیستم می افتد، در جایی ثبت می شود. ابزارهای زیر به شما کمک می کنند این اطلاعات را پیدا و تحلیل کنید.
journalctl
journalctl ابزار خط فرمان systemd برای مشاهده لاگ هاست. قدرتمند و انعطاف پذیر است و می توانید بر اساس زمان، سرویس، اولویت و سایر معیارها فیلتر کنید. چند مثال کاربردی:
journalctl -f
مشاهده زنده لاگ ها
journalctl -u nginx
لاگ های سرویس nginx
journalctl --since "10 min ago"
لاگ های 10 دقیقه اخیر
journalctl -p err
فقط خطاها
logwatch
logwatch یک ابزار تحلیل لاگ است که به صورت خودکار گزارش های خلاصه تولید می کند و می تواند آن ها را با ایمیل برای شما بفرستد. برای سرورهایی که می خواهید هر روز صبح یک گزارش از وضعیت سیستم دریافت کنید، عالی است.
sudo apt install logwatch
logwatch --detail High --mailto admin@example.com
multitail
multitail به شما اجازه می دهد چندین فایل لاگ را همزمان در یک پنجره ترمینال تماشا کنید. هر لاگ در یک پنل جداگانه با رنگ متفاوت نمایش داده می شود. برای دیباگ کردن سیستم هایی که چند سرویس دارند بسیار مفید است.
multitail /var/log/syslog /var/log/auth.log
پلتفرم های مانیتورینگ سازمانی
وقتی تعداد سرورها از یکی دو تا بیشتر می شود، ابزارهای ساده کافی نیستند. به پلتفرم هایی نیاز دارید که بتوانند چندین سرور را متمرکز مدیریت کنند، هشدار بدهند و گزارش بگیرند.
Prometheus + Grafana
این ترکیب امروزه استاندارد صنعت مانیتورینگ مدرن است. Prometheus یک سیستم جمع آوری متریک است که داده ها را از اکسپورترها (مثل Node Exporter) می کشد و در پایگاه داده سری زمانی ذخیره می کند. Grafana لایه بصری سازی است که از این داده ها داشبوردهای زیبا می سازد.
معماری این سیستم به این صورت است: روی هر سروری که می خواهید مانیتور کنید، Node Exporter نصب می کنید. این اکسپورتر متریک های سیستم را روی پورت ۹۱۰۰ تنظیم می کند. Prometheus به به صورت دوره ای این متریک ها را جمع آوری می کند. سپس Grafana به Prometheus وصل می شود و نمودارها را نمایش می دهد. Alertmanager هم هشدارها را مدیریت می کند و می تواند به ایمیل، Slack یا PagerDuty بفرستد.
wget https://github.com/prometheus/node_exporter/releases/download/v1.12.1/node_exporter-1.12.1.linux-amd64.tar.gz
tar xvf node_exporter-*.tar.gz
./node_exporter-*/node_exporter
این ترکیب به ویژه برای محیط های کانتینری و ابری عالی است چون با Kubernetes هم یکپارچه می شود.
Zabbix
Zabbix یک پلتفرم مانیتورینگ سازمانی کامل و متن باز است که از سال ۲۰۰۱ توسعه یافته و بالغ ترین گزینه در این لیست است. این ابزار می تواند سرورها، شبکه، برنامه ها و سرویس ها را مانیتور کند. رابط وب قدرتمندی دارد و امکان تعریف هشدارهای پیچیده را فراهم می کند. برای سازمان هایی که به دنبال یک راه حل یکپارچه و آماده هستند، Zabbix انتخاب اول است.
Nagios
Nagios قدیمی ترین و شناخته شده ترین پلتفرم مانیتورینگ متن باز است. اگرچه رابط کاربری آن به زیبایی Zabbix یا Grafana نیست، اما اکوسیستم پلاگین های آن بسیار گسترده است و تقریبا هر چیزی را می توان با آن مانیتور کرد. برای سازمان هایی که به یک ابزار پایدار و اثبات شده نیاز دارند، Nagios همچنان گزینه معتبری است.
Checkmk
Checkmk یک پلتفرم مانیتورینگ مدرن است که ترکیبی از سادگی Nagios و قدرت Zabbix را ارائه می دهد. نصب و پیکربندی آن ساده تر از رقباست و برای سازمان هایی که می خواهند سریع شروع کنند توصیه می شود.
جدول مقایسه پلتفرم های سازمانی:
| پلتفرم | نقطه قوت | مناسب برای |
|---|---|---|
Prometheus + Grafana |
انعطاف، استاندارد ابری | محیطهای کانتینری و مدرن |
Zabbix |
کامل، بالغ، رابط قدرتمند | سازمانهای متوسط و بزرگ |
Nagios |
پلاگین فراوان، پایداری | زیرساختهای سنتی |
Checkmk |
نصب آسان، رابط مدرن | شروع سریع |
Netdata |
بلادرنگ، مصرف کم | نظارت بر عملکرد |
ابزارهای سبک برای موارد خاص
علاوه بر ابزارهای اصلی، چند ابزار کوچک و مفید هم وجود دارند که برای کارهای خاص عالی هستند:
-
iotop: نمایش فرآیندهایی که بیشترین I/O دیسک را دارند. مثل
topاما برای دیسک. -
pidstat: مانیتورینگ CPU، حافظه و I/O یک فرآیند خاص.
-
mpstat: نمایش مصرف هر هسته CPU به صورت جداگانه.
-
lsof: نمایش فایل های باز شده توسط فرآیندها. برای پیدا کردن فایل های قفل شده مفید است.
-
strace: ردیابی تماس های سیستمی یک فرآیند. برای دیباگ برنامه ها عالی است.
-
nmon: یک ابزار جامع که CPU، حافظه، دیسک و شبکه را در یک نمای واحد نشان می دهد.

چگونه ابزار مناسب را انتخاب کنیم؟
انتخاب ابزار مانیتورینگ به عوامل مختلفی بستگی دارد:
اگر یک سرور شخصی دارید:
htop + glances + Netdata ترکیب عالی و رایگانی است. htop برای عیب یابی سریع، glances برای نمای کامل و Netdata برای داشبورد زیبا کافی است.
اگر یک استارتاپ کوچک هستید:
Netdata یا Cockpit را روی سرورها نصب کنید. اگر تعداد سرورها بیشتر شد، به Prometheus + Grafana مهاجرت کنید.
اگر یک سازمان متوسط دارید:
Zabbix یا Checkmk انتخاب های مطمئنی هستند. هر دو پشتیبانی تجاری دارند و می توانند صدها سرور را مدیریت کنند.
اگر محیط ابری و کانتینری دارید:
Prometheus + Grafana + Alertmanager استاندارد صنعت است. با Node Exporter برای سرورها و kube-state-metrics برای کوبرنتیز.
اگر بودجه محدودی دارید:
همه ابزارهای ذکر شده در این مقاله متن باز و رایگان هستند. فقط هزینه سرور و زمان یادگیری را در نظر بگیرید.
نکات عملی و بهترین شیوه ها
-
از چند ابزار استفاده کنید، نه فقط یکی.
htopبرای عیب یابی سریع،Netdataبرای داشبورد وPrometheusبرای هشداردهی. هر کدام جایگاه خودشان را دارند. -
هشداردهی را جدی بگیرید. مانیتورینگ بدون هشدار مثل نگهبان خواب آلود است.
Alertmanagerیا ماژول هشدارZabbixرا پیکربندی کنید. -
داده های تاریخی را ذخیره کنید.
sarوPrometheusداده های گذشته را نگه می دارند. برای تحلیل روندها و پیدا کردن الگوهای مشکل دار ضروری است. -
مصرف منابع خود ابزارها را فراموش نکنید.
Netdataسبک است اماPrometheusبا داده های زیاد می تواند حافظه زیادی مصرف کند. منابع را متناسب با مقیاس تنظیم کنید. -
امنیت را رعایت کنید. داشبوردهای وب مثل
NetdataوCockpitرا در معرض اینترنت قرار ندهید. از VPN یا فایروال استفاده کنید.
نتیجه گیری
لینوکس یکی از غنی ترین اکوسیستم های ابزارهای مانیتورینگ را در دنیای فناوری دارد. از دستورات ساده ترمینال مثل top و vmstat گرفته تا ابزارهای TUI مدرن مثل btop و glances، از داشبوردهای وب محور مثل Netdata و Cockpit تا پلتفرم های سازمانی مثل Zabbix و Prometheus + Grafana. هر نیازی که داشته باشید، ابزاری برای آن وجود دارد.
کلید موفقیت این است که با یک یا دو ابزار ساده شروع کنید و به تدریج بر اساس نیازتان موارد بیشتر را استفاده کنید. لازم نیست از روز اول Prometheus راه اندازی کنید. با htop و Netdata شروع کنید، با سیستم آشنا شوید و وقتی تعداد سرورها یا پیچیدگی محیط افزایش یافت، به سراغ راه حل های سازمانی بروید. مانیتورینگ یک سفر است، نه یک مقصد. هر چه بیشتر با این ابزارها کار کنید، درک عمیق تری از سیستم های لینوکس پیدا خواهید کرد و می توانید مشکلات را قبل از اینکه کاربران متوجه شوند حل کنید.